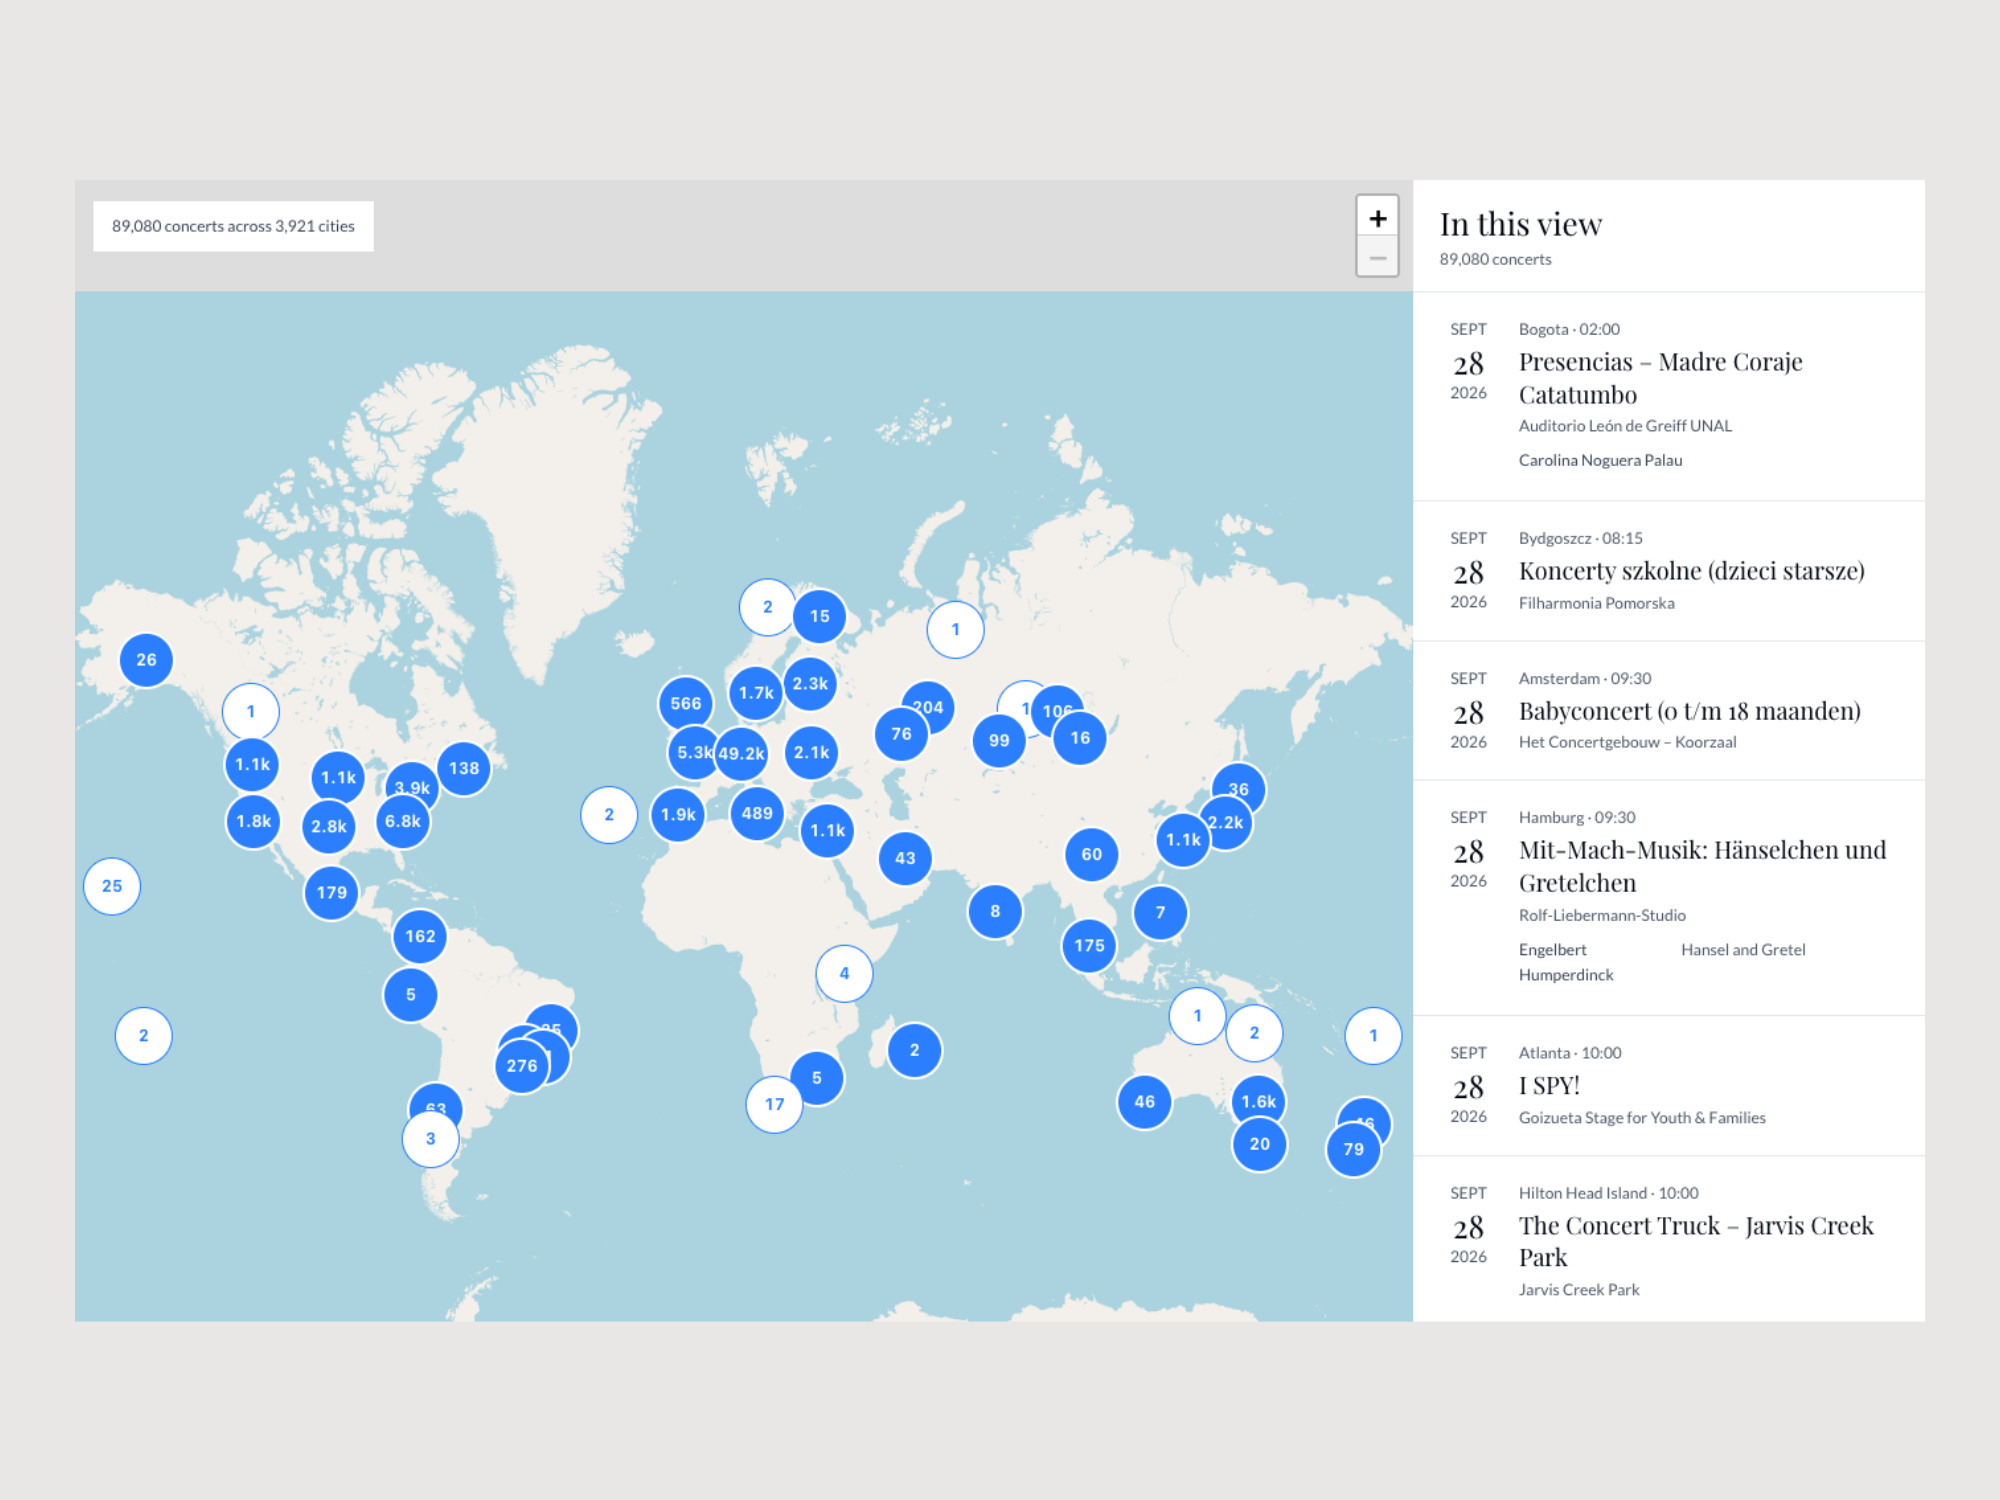
ClassicalBot, un projet slovaque, utilise l’intelligence artificielle pour suivre plus de 70 000 concerts de musique classique dans le monde, grâce à un système baptisé crawler factory
.
ClassicalBot, un projet développé par le développeur slovaque Róbert Druska, utilise l’intelligence artificielle (IA) pour indexer plus de 70 000 concerts de musique classique à travers le monde, provenant de plus de 4 000 sources. Ce système, présenté comme une innovation technologique, repose sur une approche automatisée qui réduit le besoin de travail humain, selon les informations fournies par les sources.
Le fonctionnement du « crawler factory »
Le processus repose sur un « magic box » qui génère automatiquement des « crawlers » (programmes de collecte de données) pour des sites web, en évitant la nécessité d’interventions manuelles. Selon ClassicalBot, cette méthode a permis de traiter des dizaines de milliers de sources, avec une efficacité accrue grâce aux outils d’IA comme le Codex SDK d’OpenAI et l’Agent SDK d’Anthropic. Les crawlers sont ensuite validés et intégrés via des demandes de pull (PR) sur GitHub, permettant une automatisation quasi totale.
« Ce système est conçu pour être réutilisable dans d’autres domaines, comme la collecte de menus de restaurants, de prix d’e-shops ou d’offres d’emploi », a déclaré Druska, soulignant le potentiel d’extension de cette technologie. Les sources mentionnent également l’utilisation de modèles comme GPT-5.6-Luna pour l’analyse des programmes de concerts, remplacant les APIs de LLM précédentes.
Des origines modestes à une expansion mondiale
ClassicalBot a commencé comme un projet local, couvrant les concerts de musique classique en Slovaquie, un pays à faible densité de contenus en ligne sur le sujet. Le premier prototype, publié sur classical.sk, nécessitait une recherche manuelle des sites web et la création de crawlers individuels. En 2026, l’automatisation a permis d’étendre le projet à l’échelle mondiale, avec un coût réduit à une seule souscription à un service d’IA.
« Ce projet a été conçu comme une expérimentation sur les limites de l’automatisation par l’IA », a expliqué Druska. Il a ajouté que les étapes de traitement des données, comme la nettoyage et l’extraction des programmes, sont désormais gérées par des modèles d’IA, réduisant les coûts et les délais.
Les défis et les perspectives
Malgré son succès, le système reste dépendant de la qualité des sources web, avec des taux d’échec pour certains sites. Les sources indiquent que des retours d’erreur sont gérés par des réessais automatisés, mais certaines plateformes nécessitent une intervention humaine. L’avenir du projet repose sur l’amélioration des outils d’IA, qui devraient rendre l’automatisation encore plus fiable et économique.
« L’idée d’une usine de crawlers automatisée pourrait être étendue à d’autres cas d’usage », a affirmé Druska dans une interview. Il a mentionné des applications potentielles comme la collecte de données sur les entreprises, les événements ou les offres d’emploi, ouvrant la voie à une numérisation plus complète du web.
Pour aller plus loin